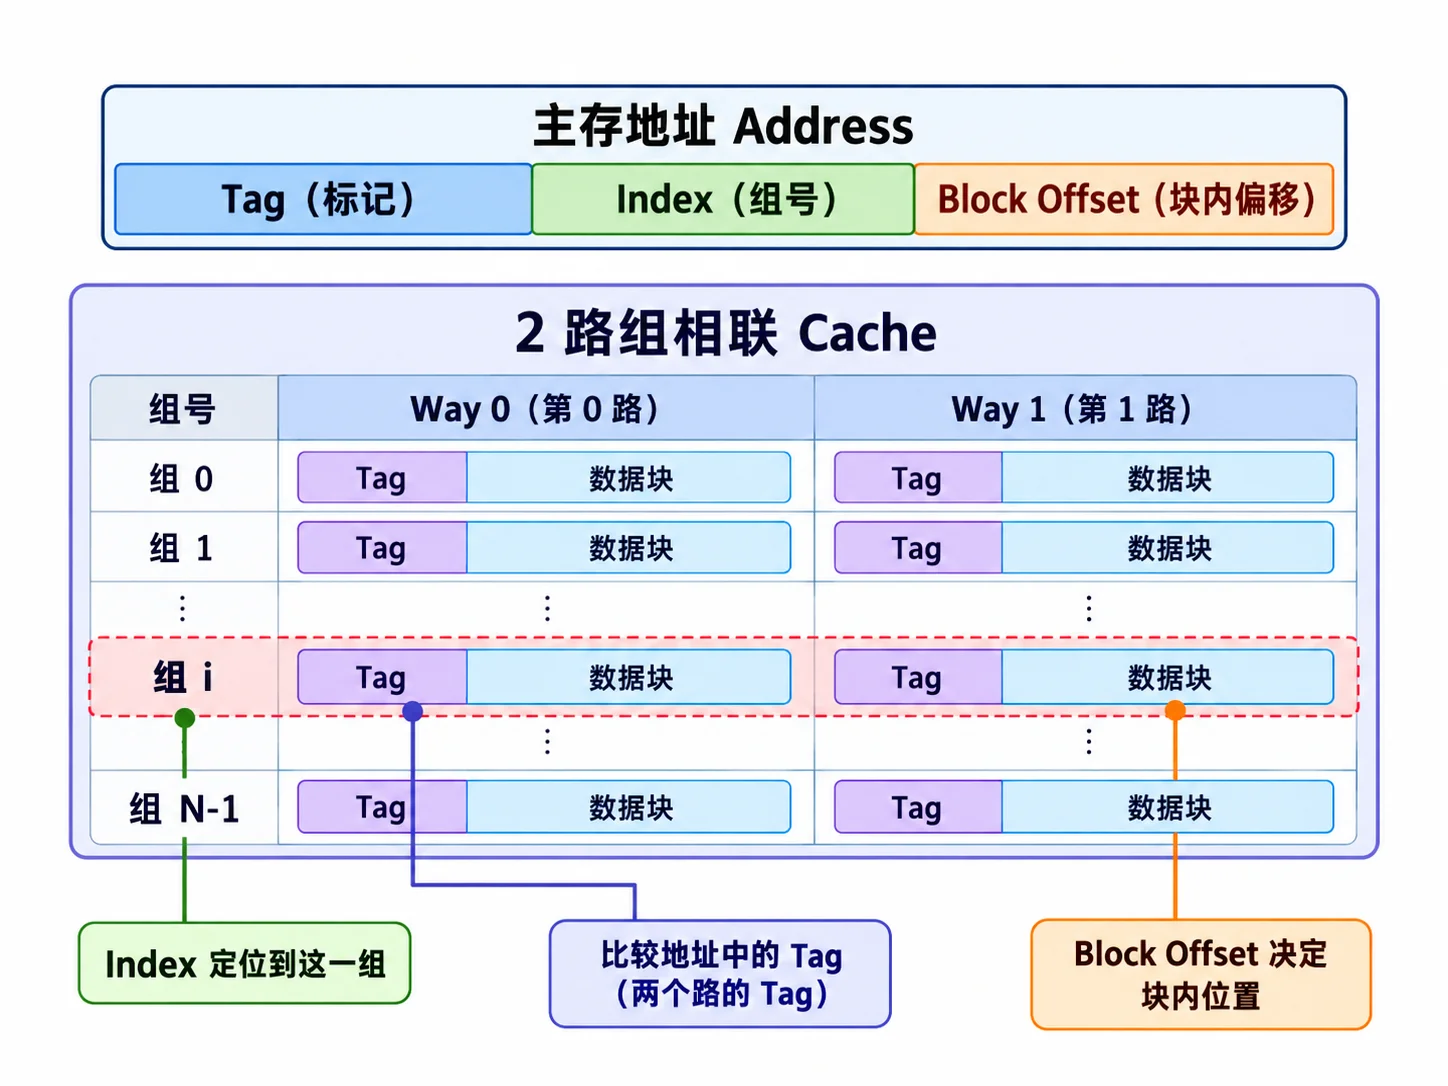
技巧 1:Index + Offset 就是单路容量#
如上图:
{单路容量Tag 位数=Cache 容量÷路数=2Index+Offset B=地址位数−(Index+Offset)
题目不给地址位数、只给主存大小时,主存除以单路容量就行:
Tag 位数=log2(主存÷单路容量)
比如主存 4GB,一路容量 8KB,就是 232÷213=219,Tag 还是 19 位。
技巧 2:十六进制消消乐#
题目一般会给一个十六进制地址,问它在第几组。地址由 Tag + Index + Offset 拼成,求组号其实就是求 Index:把头上的 Tag 和尾巴的 Offset 砍掉,剩下的就是。
注意: 不用把整个地址展开成二进制。1 个十六进制位 = 4 个二进制位,只展开被 Tag、Offset 截断的那一两位就行,如下:
技巧 3:数组地址跳跃#
数组名后面第一个方括号是第一维,第二个是第二维,依次类推:
int a第一维[64]第二维[64]
C 语言按行优先存放,最后一维的元素挨着放:a[0][0]、a[0][1]……a[0][63] 放完,才轮到 a[1][0]。第一维每加 1,地址就跳过一整个第二维,也就是 64×4B。
注意: 判断同组的标准做法是比 Index 是否相同。相减是单路容量的整数倍,只是一个快速判断:是整数倍,就一定同组;不是整数倍,还得回去比 Index。比如 Index + Offset 共 13 位,单路容量就是 0x2000。0x12347AC8 和 0x9876FAC0 尾巴一个 8 一个 0,相减不是 0x2000 的整数倍,但 Index 相同,照样同组。
技巧 4:Cache 硬件总容量#
注意区分 Cache 数据容量和 Cache 硬件总容量。硬件不光存数据,每一块还要额外存 Tag,以及题目给的各种状态位。比如:
- 有效位:1 位,标记这格有没有装数据。
- 脏位:题目说采用回写法,就加 1 位。
- LRU 替换位:K 路 LRU 就是 log2K 位。
总容量=总块数×(Tag+状态位+块大小×8)
其中,总块数 = Cache 容量 ÷ 块大小,也等于路数 × 2Index。
注意: 数据位 = 块大小 × 8,64B 就是 512 位。Offset 是地址里的字段,Cache 里不存。
技巧 5:数组顺序遍历命中率#
一个 Cache 块能装下的元素个数:
N=块大小÷单个元素大小
变形一:除不尽,向上取整算 Miss#
int a[64][64],第二维 64 个元素,但内层循环只跑前 50 个(j < 50):
块 116 个块 216 个块 316 个块 42 个
- 50 个元素要搬几块?⌈50÷16⌉=4 块,前 3 块装 48 个,第 49、50 个逼着硬件去搬第 4 块。
- 搬 4 块就是 4 次 Miss。访问 50 次,Miss 4 次,命中率 5050−4=92%。
变形二:看清有没有赋值(一读一写,访问翻倍)#
对比这两行(假设 sum 在寄存器里):
sum += a[i];:只对 a[i] 做一次读(Load)。a[i] = a[i] + 10;:先把 a[i] 读(Load)出来加 10,再把结果写(Store)回 a[i]。
每个元素 1 次 Load + 1 次 Store,共 2 次访存。第一次 Load 就算 Miss,块也已经搬进 Cache 了,紧接着对同一个 a[i] 的 Store 一定命中。
块内 16 个元素一共 16×2=32 次访存,还是只有开头 1 次 Miss,命中率从 1615 变成 3231。
看到 a[i] = a[i] + ...,访问次数乘 2,Miss 次数不变。
变形三:外层套循环重复遍历(Miss 率被稀释)#
外面套一层 for (int k = 0; k < 10; k++),而且整个数组不超过 Cache 容量(能全部塞进 Cache):
- 只有第 1 遍(
k = 0)有 Miss。
- 第 2 到 10 遍,整个数组已经在 Cache 里了,全部命中。
总 Miss 数不变,总访问次数乘 10,未命中率从 161 稀释成 161÷10=1601。
技巧 6:按列遍历与颠簸(Thrashing)#
二维数组按列遍历(外层 j++,内层 i++ 跨行跳)时,访问完 a[0][0](把 a[0][0..15] 搬进 Cache),下一步却跳去下一行的 a[1][0],刚搬进来的 a[0][1..15] 一个都没用上。
等第 0 列扫完、外层来到 j = 1 去访问 a[0][1] 时,a[0][0..15] 还在不在 Cache 里?
这取决于扫第 0 列的过程中,映射到同一组的那些行有没有把它挤出去。地址每差一个单路容量,就落回同一组。一列从上扫到下,跨过几个单路容量,同一组就要挤进几块:
同组竞争块数=一列跨过的字节数÷单路容量
- 同组竞争块数 > 路数:同一组装不下,先进来的块等不到下一列就被踢走,这就是颠簸(Thrashing)。只读命中率 0%,一读一写 50%。过程见综合题第 3 问。
- 同组竞争块数 ≤ 路数:第 0 列扫完,搬进来的块全都还在,后面几列全部命中。命中率和按行遍历一样,是 1−N1。
综合题#